
WAND-Vega와 HY 3D로 영화 같은 원테이크 샷 구현하기
카메라 한 대가 컷 없이 처음부터 끝까지 이어 찍는 촬영 방식을 원테이크(one-take)라고 부릅니다. 도박장 문을 열고 들어오는 인물 둘을 원테이크로 찍고 싶다고 해봅니다. 조명은 어떻고, 두 사람이 어느 방향에서 들어오는지, 카메라가 그 뒤를 따라가는지 아니면 고정된 자리에서 지켜보는지, 이 모든 걸 프롬프트 문장 하나에 눌러 담아야 합니다. 결과가 원하는 그림과 조금이라도 다르면 손댈 방법이 없어서 클립 전체를 처음부터 다시 뽑는 수밖에 없습니다.
AI 영상 제작 툴 Higgsfield는 이 문제를 다른 방식으로 풉니다. 영상을 생성하는 AI 앞에, 영상을 생성하지 않는 AI(GPT-6 Astra)를 하나 세워서 장면을 몇 개의 구역(zone)으로 나누고 인물이 그 구역을 지나가는 동선과 카메라 경로까지 먼저 설계도로 뽑아둡니다. 그다음에야 실제 렌더링 모델인 Seedance 2.5가 그 설계를 바탕으로 영상을 찍습니다. 프롬프트 한 줄이 아니라 도면 한 장에서 출발하는 셈입니다.
이번 글에서는 같은 아이디어를 Text LLM과 HY 3D, WAND-Vega로 직접 재현해봤습니다.
세 모델을 이어 붙이는 조합
Higgsfield가 하는 역할을 그대로 대응시키면 아래처럼 정리됩니다.
| Higgsfield 역할 | 이번 실험 조합 |
|---|---|
| GPT-6 Astra (그리지 않는 AI, 장면 설계) | Text LLM — 장면을 JSON으로 구조화 |
| Higgsfield MCP + Blender (3D 공간) | HY 3D — 360° 파노라마로 공간 프리뷰 |
| Seedance 2.5 (최종 렌더) | WAND-Vega — 최종 시네마틱 렌더링 |
세 모델 모두 Tencent Cloud의 AIGC 모델입니다. 흐름을 그림으로 정리하면 아래와 같습니다.
Step 1. Text LLM이 장면을 짠다
카지노 장면 아이디어를 프롬프트로 던지면 Text LLM이 구역과 캐릭터, 카메라를 구조화된 JSON으로 돌려줍니다. 실제 출력을 발췌하면 이렇습니다.
{
  "title": "Smoke and Green Felt",
  "zones": [
    {"id": 1, "name": "Rain-Slicked Street Approach",
     "description": "A narrow, rain-slicked side street with flickering neon reflections..."},
    {"id": 2, "name": "Concrete Service Corridor",
     "description": "A tight concrete hallway with exposed pipes..."},
    {"id": 3, "name": "Dim Threshold Antechamber",
     "description": "A small, low-ceilinged threshold space with a heavy soundproof door..."},
    {"id": 4, "name": "Smoky Gaming Floor",
     "description": "A wide casino floor with rows of green-felt gaming tables..."}
  ],
  "characters": [
    {"name": "Man in Charcoal Overcoat",
     "look": "Mid-30s, sharp features, charcoal overcoat over a loosened tie...",
     "path": [1, 2, 3, 4]},
    {"name": "Woman in Red Dress",
     "look": "Late 20s, wavy dark hair, form-fitting red cocktail dress...",
     "path": [1, 2, 3, 4]}
  ],
  "camera": {"type": "Steadicam", "movement": "Begins with a low-angle tracking shot..."},
  "main_shot": {"zone_id": 4, "prompt": "A slow-rising 3/4 frontal shot on the smoky casino gaming floor..."}
}
거리, 통로, 대기 공간, 도박장까지 네 구역을 순서대로 지나가는 동선과 두 캐릭터의 생김새("charcoal overcoat over a loosened tie", "form-fitting red cocktail dress")를 한 번에 뽑아준 겁니다. 이 묘사는 아래 최종 영상에서 그대로 재현됩니다.
Step 2. HY 3D가 공간을 미리 보여준다
main_shot이 가리키는 4번 구역, 도박장을 HY 3D로 먼저 만들어봤습니다.
- 출력: 7680 × 3840 equirectangular 360° 파노라마 (약 38MB)
- 뷰어로 열면 마우스 드래그로 공간을 둘러볼 수 있습니다.
실제 촬영이라면 로케이션 헌팅에 해당하는 단계입니다. 조명 톤과 테이블 배치, 공간감을 렌더링 전에 미리 확인할 수 있습니다.
Step 3. WAND-Vega가 찍는다
main_shot.prompt를 WAND-Vega에 넘기면 최종 시네마틱이 나옵니다.
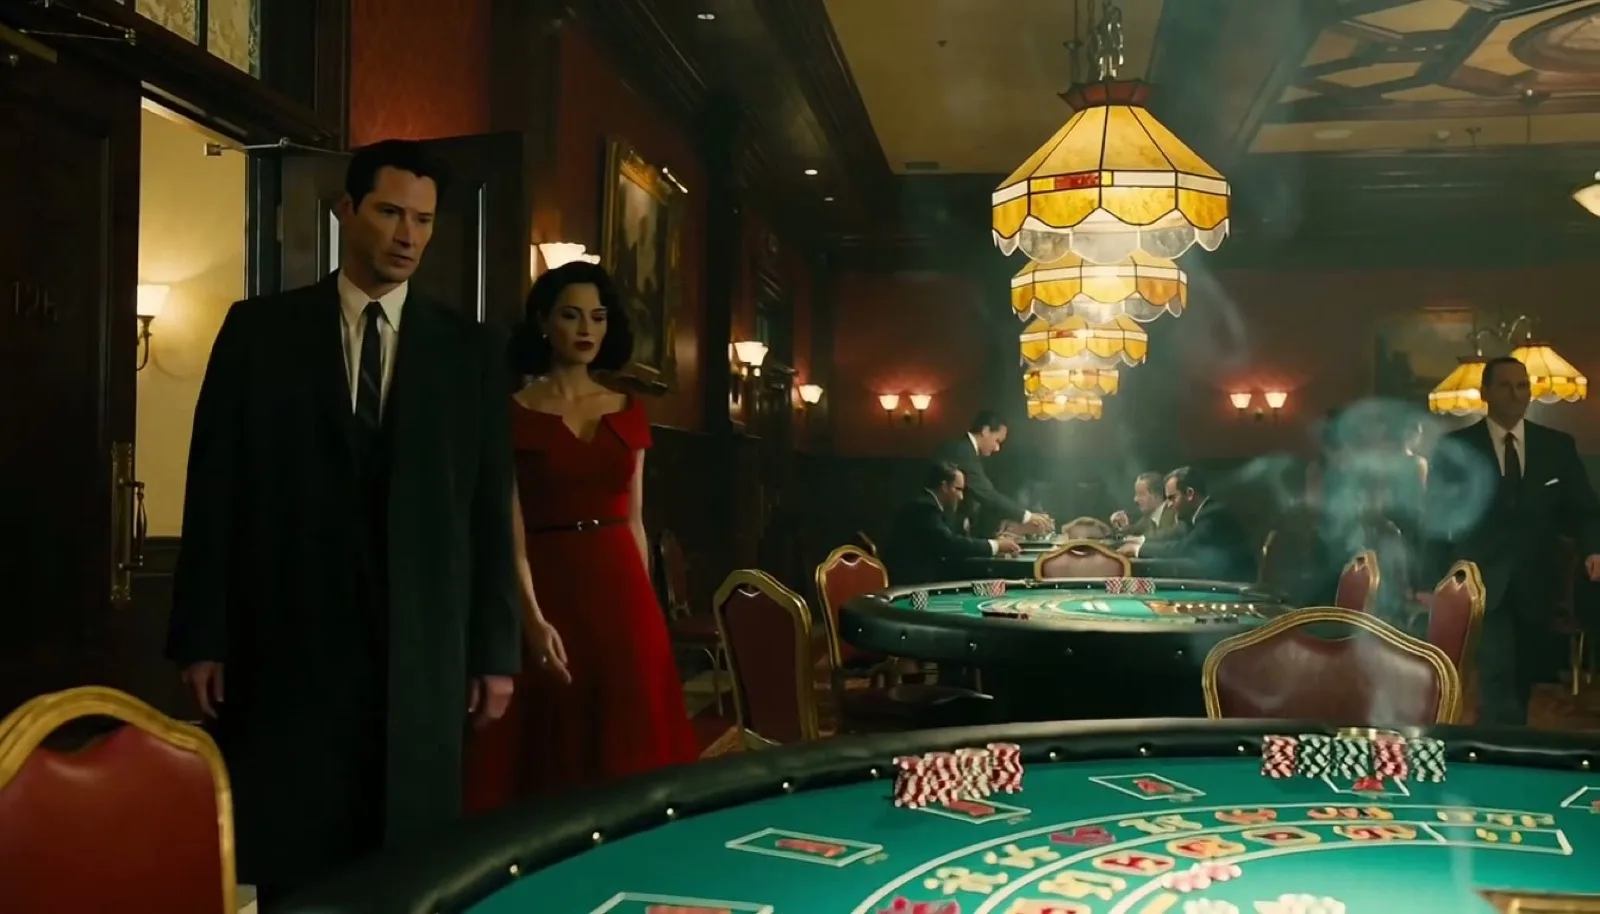
전체 영상 보기 — 1344 × 768 (16:9), H.264 + AAC, 8.33초
도박장 문을 열고 들어오는 차콜 오버코트의 남자와 빨간 드레스의 여자, 따뜻한 텅스텐 펜던트 조명, 옅게 낀 담배 연기, 초록 펠트 테이블까지 Text LLM이 짠 묘사가 화면에 그대로 옮겨졌습니다.
걸린 시간
전체 파이프라인 소요 시간을 재보면 Text LLM 약 10초, HY 3D 약 90초, WAND-Vega 약 120초로 합쳐서 4분 안팎입니다. 프롬프트를 던지고 커피 한 잔 내리는 사이에 장면 설계부터 완성 영상까지 나오는 셈입니다.
마치며
"프롬프트를 그대로 던지는 것"과 "장면을 구조화하고 공간을 먼저 훑어본 다음 찍는 것" 사이에는 품질과 통제력 차이가 분명합니다. 이번 핸즈온에서 확인한 건 그 구조의 첫 단추인 장면 설계 레이어를 Text LLM만으로도 지금 당장 실현할 수 있다는 겁니다. Higgsfield가 GPT-6 Astra로 보여준 "찍기 전에 짓는다"는 방향을 HY 3D와 WAND-Vega를 이어 붙이는 것만으로 같은 카지노 장면에서 확인했습니다.