
통합 AI 플랫폼: Tencent Cloud MPaaS AIGC
VOD AIGC
최근 생성형 AI 시장은 OpenAI, Google, Anthropic, Kling, PixVerse, Hunyuan 등 수많은 벤더들이 경쟁하는 시대가 되었습니다. 사용자 입장에서는 선택지가 많아졌지만, 서비스 운영 관점에서는 어떤 모델을 선택하고 어떻게 연동할지 고민도 함께 늘어났습니다.
Tencent Cloud는 이를 개별 모델 경쟁이 아닌 플랫폼 관점에서 접근하고 있습니다. 특정 모델 하나를 제공하는 대신, 전 세계 주요 Text, Image, Video 생성 모델들을 통합 제공하는 형태입니다. 사용자는 목적에 따라 다양한 모델을 선택할 수 있고, 서비스는 모델 교체나 추가 도입에 대한 부담을 줄일 수 있습니다.
흥미로운 점은 이러한 AI 기능이 별도의 AI 제품이 아니라 VOD 안에 통합되어 있다는 점입니다. 처음에는 다소 의외로 보일 수 있지만, 생성된 이미지와 영상도 결국 하나의 미디어 자산(Asset)이라는 점을 생각하면 자연스러운 선택입니다. 생성된 콘텐츠를 저장하고, 관리하고, 후처리하고, 배포하는 과정은 기존 VOD 파이프라인과 맞닿아 있기 때문입니다.
결국 Tencent Cloud VOD AIGC는 단순한 AI 모델 API 모음이 아니라, 생성형 AI와 미디어 자산 관리 파이프라인을 하나로 연결한 플랫폼에 가깝습니다. 이 글에서는 Tencent Cloud VOD AIGC의 구조를 살펴보고, 이미지 생성부터 영상 생성까지의 기본적인 Hands-on 과정을 정리해보겠습니다.
전체 구조
VOD AIGC는 크게 세 갈래로 볼 수 있습니다.
| 영역 | 목적 | 결과물 |
|---|---|---|
| Text LLM | 영상 기반 요약, 코드 작성 등 | 텍스트 |
| Image Generation | 프롬프트 기반 이미지 생성 | 이미지 URL |
| Video Generation | 프롬프트 기반 영상 생성 | 비디오 URL |
텍스트 쪽은 OpenAI 호환 인터페이스를 제공합니다. base URL을 바꿔서 Chat Completions나 Responses API 형태로 붙일 수 있습니다. 기존 도구가 OpenAI SDK를 기준으로 만들어져 있다면, 인증과 endpoint만 바꿔서 테스트할 수 있는 구조입니다.
이미지와 비디오는 MPS의 비동기 task로 동작합니다. 요청을 보내면 바로 결과가 떨어지는 게 아니라 TaskId를 받고, DescribeTaskDetail로 상태를 확인합니다. 영상 생성은 수십 초에서 수 분까지 걸릴 수 있으니 이 방식이 더 현실적입니다. 동기 API로 붙이면 첫 번째 장애는 모델이 아니라 timeout에서 터집니다.
제공 모델
전 세계 거의 모든 모델을 지원합니다. Text는 Claude, Gemini , Chatgpt과 같은 서비스모델을 제공하고 이미지 및 영상도 지금 시장에 나와있는 모든 모델이 통합되어 있습니다. 정확한 지원 모델 목록은 콘솔 문서에서 최신 버전을 확인하는 게 안전합니다.
실습 목표
이번 hands-on에서는 아래 흐름을 만듭니다.
- 텍스트 프롬프트로 기준 이미지 생성
- 생성된 이미지 URL 확인
- 해당 이미지를 reference로 넣어 짧은 영상 생성
- 결과 영상 URL 확인
- VOD 자산으로 이어 붙일 때 고려할 점 정리
예시 시나리오는 “클라우드 미디어 파이프라인을 설명하는 짧은 제품 소개 컷”으로 잡습니다. 너무 예술적인 프롬프트보다 이런 설명형 컷이 제품 데모에 더 잘 맞습니다. 멋진 영상 하나 뽑는 것도 좋지만, 실무에서는 다시 쓸 수 있는 프롬프트와 반복 가능한 파라미터가 더 중요합니다.
사전 준비
실습 전에 필요한 것은 세 가지입니다.
| 항목 | 설명 |
|---|---|
| Tencent Cloud 계정 | VOD/MPS API를 호출할 계정 |
| API SecretId / SecretKey | Tencent Cloud API 인증 |
| Python SDK | tencentcloud-sdk-python |
Python SDK는 아래처럼 설치합니다.
pip install tencentcloud-sdk-python환경 변수로 인증 정보를 넣습니다.
export TENCENTCLOUD_SECRET_ID="your-secret-id"
export TENCENTCLOUD_SECRET_KEY="your-secret-key"
실제 키를 코드에 박아두면 나중에 git history 보면서 인간성이 사라집니다. 이런 건 보통 “테스트니까 괜찮겠지”에서 시작해서, 몇 달 뒤 보안 리뷰에서 모두가 겸손해집니다. 환경 변수나 secret manager를 쓰는 게 맞습니다.
1단계: 이미지 생성 테스크 만들기
먼저 텍스트 프롬프트로 이미지를 만듭니다. 여기서는 제품 소개용 키 비주얼을 만든다고 가정합니다.
import os
import time
from tencentcloud.common import credential
from tencentcloud.mps.v20190612 import mps_client, models

cred = credential.Credential(
    os.environ["TENCENTCLOUD_SECRET_ID"],
    os.environ["TENCENTCLOUD_SECRET_KEY"],
)

client = mps_client.MpsClient(cred, "")

req = models.CreateAigcImageTaskRequest
req.Prompt = (
    "A clean cinematic product visual of a cloud media pipeline, "
    "video files flowing into AI processing nodes, modern data center, "
    "subtle teal light, realistic, high detail"
)
req.ModelName = "Kling"
req.ModelVersion = "3.0-Omni"

extra = models.AigcImageExtraParam
extra.AspectRatio = "16:9"
req.ExtraParameters = extra

resp = client.CreateAigcImageTask(req)
print(resp.TaskId)
여기서 중요한 건 모델명, 버전, aspect ratio 조합입니다. 이미지 생성 모델은 모델마다 받는 파라미터가 조금씩 다릅니다. 문서상 같은 AspectRatio처럼 보여도 내부 모델이 허용하는 값이 다르면 task가 거부됩니다. 이건 정상 동작이라기보다 모델 게이트웨이 특유의 현실입니다.
2단계: 이미지 결과 polling
TaskId를 받았으면 완료될 때까지 상태를 확인합니다.
def wait_image(task_id: str):
    while True:
        req = models.DescribeTaskDetailRequest
        req.TaskId = task_id
        result = client.DescribeTaskDetail(req)

        print(result.Status)

        if result.Status == "FINISH":
            return result.AigcImageTask.Output.ImageUrl

        if result.Status in ("FAIL", "ABORTED"):
            message = getattr(result.AigcImageTask, "Message", "AIGC image task failed")
            raise RuntimeError(message)

        time.sleep(2)
polling 간격은 너무 촘촘하게 잡지 않는 게 좋습니다. 0.1초마다 때리면 빨라지는 게 아니라 API만 괴롭히는 수준입니다. 보통 이미지 task는 1~2초 간격, 영상 task는 3~5초 간격이면 충분합니다.
결과 URL을 받으면 브라우저에서 열어 확인합니다.
image_url = wait_image(resp.TaskId)
print(image_url)
3단계: 생성된 이미지를 기반으로 영상 만들기
이제 이미지 URL을 reference로 넣어서 짧은 영상을 만듭니다. 이 단계가 i2v(image-to-video)입니다.
req = models.CreateAigcVideoTaskRequest
req.Prompt = (
    "Camera slowly moves through the cloud media pipeline, "
    "AI processing nodes light up one by one, "
    "smooth cinematic motion, no text overlay"
)
req.ModelName = "Kling"
req.ModelVersion = "3.0-Omni"
req.InputImage = image_url

extra = models.AigcVideoExtraParam
extra.Resolution = "1080P"
extra.AspectRatio = "16:9"
req.ExtraParameters = extra

video_resp = client.CreateAigcVideoTask(req)
print(video_resp.TaskId)
텍스트만으로 영상을 만들 수도 있지만, 제품 소개나 서비스 데모에서는 reference 이미지를 넣는 쪽이 훨씬 안정적입니다. 첫 프레임의 구성과 색감이 잡히기 때문입니다. 텍스트만 던지면 모델이 상상력을 발휘합니다. 문제는 그 상상력이 보통 브랜드 가이드라인을 안 읽는다는 점입니다.
4단계: 영상 결과 polling
영상은 이미지보다 오래 걸립니다. timeout을 넉넉하게 잡아야 합니다.
def wait_video(task_id: str):
    while True:
        req = models.DescribeTaskDetailRequest
        req.TaskId = task_id
        result = client.DescribeTaskDetail(req)

        print(result.Status)

        if result.Status == "FINISH":
            return result.AigcVideoTask.Output.VideoUrl

        if result.Status in ("FAIL", "ABORTED"):
            message = getattr(result.AigcVideoTask, "Message", "AIGC video task failed")
            raise RuntimeError(message)

        time.sleep(5)

video_url = wait_video(video_resp.TaskId)
print(video_url)
영상 생성은 모델 상태, 해상도, duration, reference 이미지 복잡도에 따라 시간이 흔들립니다. 이걸 사용자 화면에서 동기 로딩으로 묶으면 브라우저가 먼저 지칩니다. 실제 제품으로 만들 때는 task queue와 상태 화면을 분리하는 게 좋습니다.
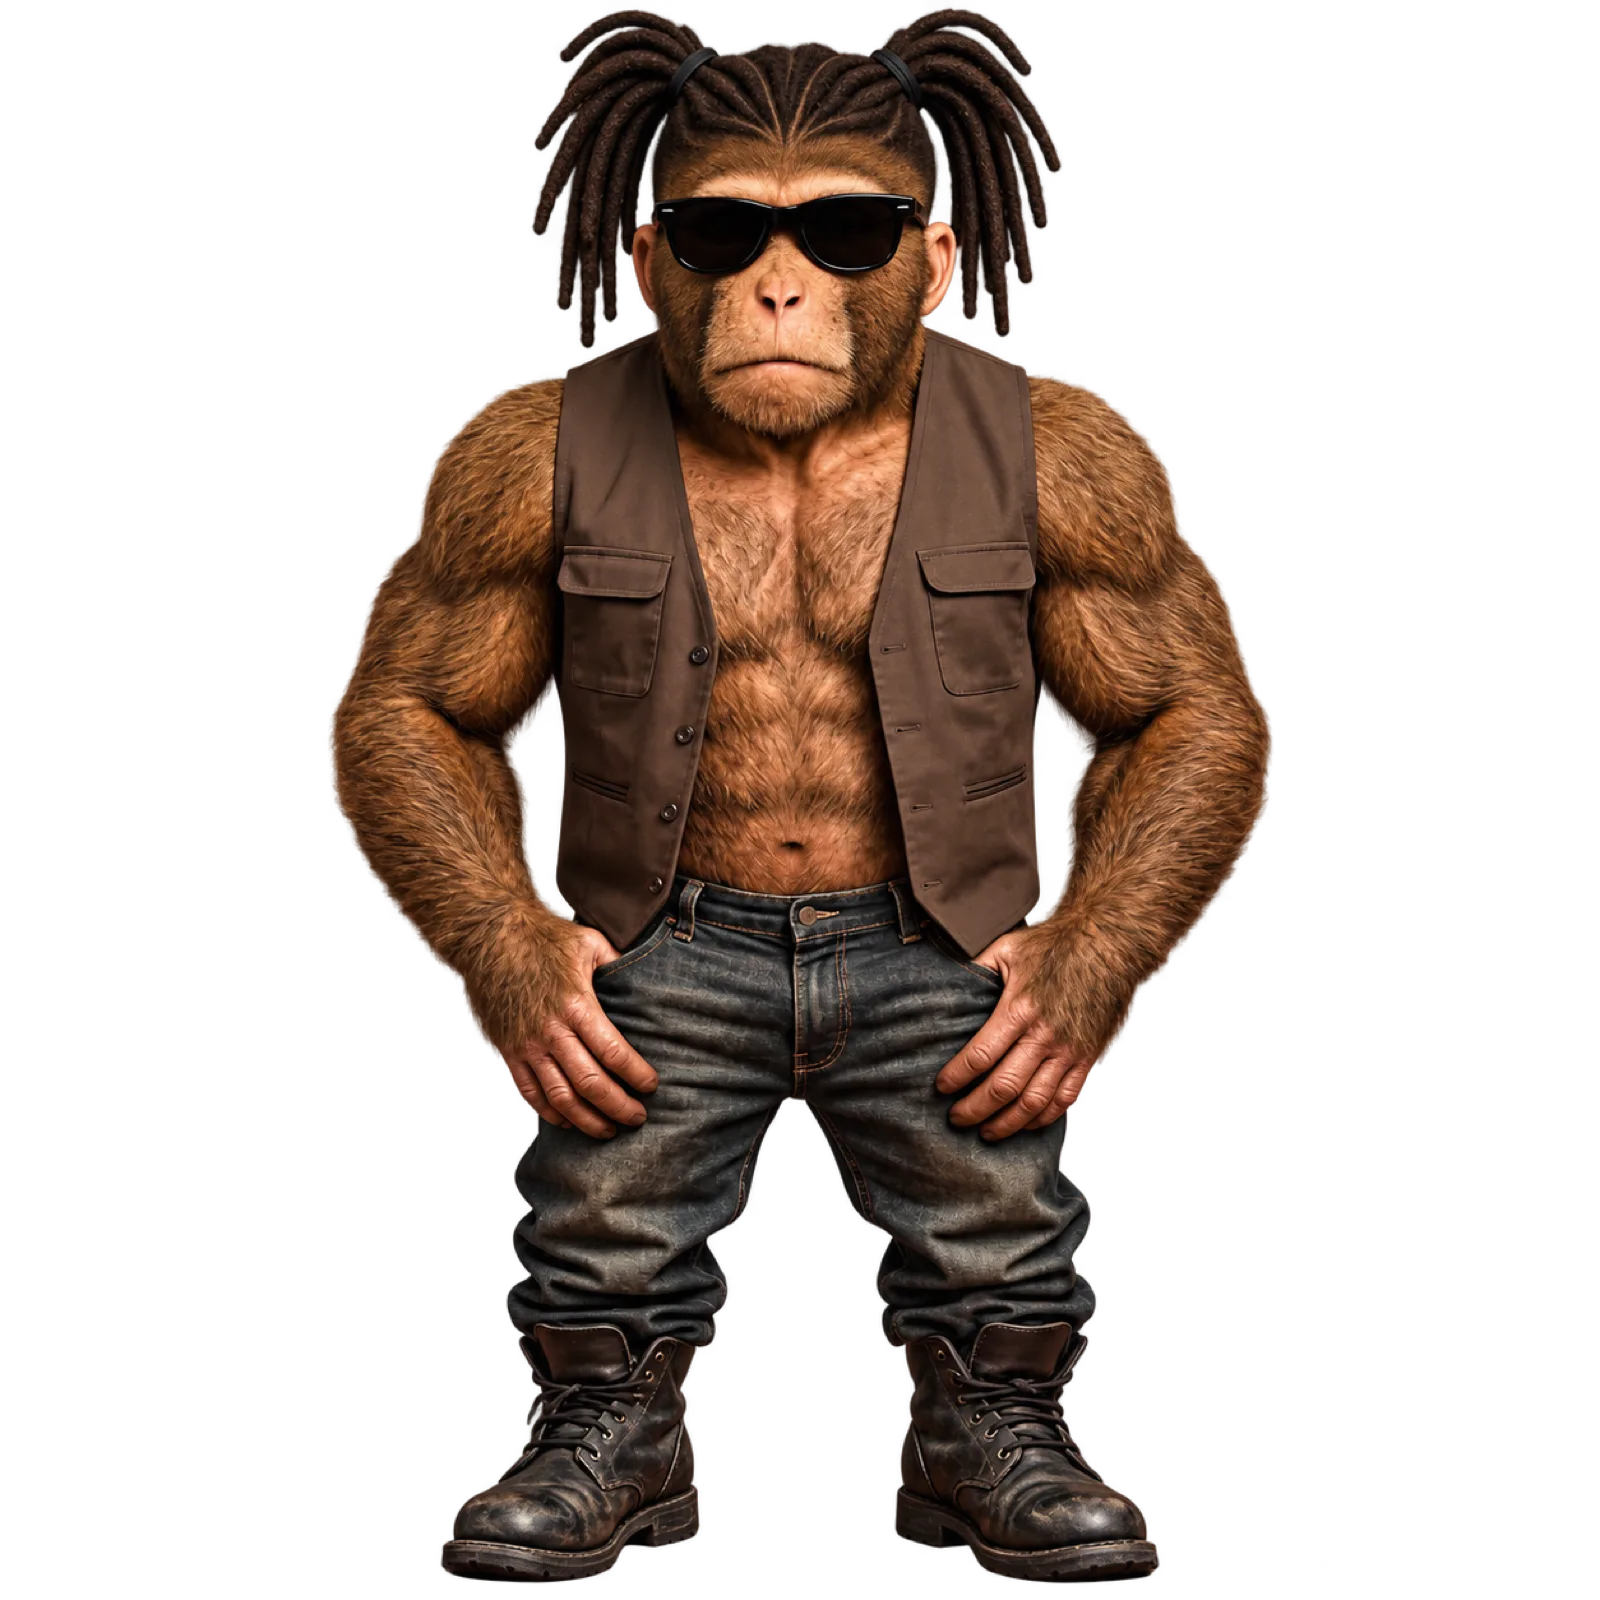
영상 생성 결과 예시
AIGC의 가장 큰 장점은, 한 개의 프롬프트로 모든 AI영상 벤더에 동시요청을 날려서 효과를 비교해볼 수 있다는 점에 있습니다.
5단계: 결과물을 VOD 자산 흐름에 붙이기
생성된 영상 URL을 받았다고 끝은 아닙니다. 실제 서비스에서는 이 결과물을 다시 VOD 자산으로 관리할지 결정해야 합니다.
| 선택지 | 의미 | 적합한 경우 |
|---|---|---|
| 결과 URL만 사용 | 생성 결과 URL을 바로 노출 | 내부 PoC, 임시 리뷰 |
| VOD로 재수집 | 생성 결과를 VOD asset으로 등록 | 서비스 노출, 재사용 |
| 후처리 workflow 연결 | 썸네일, 자막, DRM, ABR 생성 | 실제 사용자 대상 배포 |
PoC라면 결과 URL만 열어봐도 됩니다. 하지만 사용자에게 제공할 콘텐츠라면 VOD asset으로 다시 넣는 쪽이 맞습니다. 그래야 이후 트랜스코딩, 썸네일, 워터마크, DRM, CDN 배포 정책을 같은 파이프라인에서 태울 수 있습니다.
생성형 AI 결과물도 결국 미디어 파일입니다. 파일이 생겼으면 저장 위치, 만료 정책, 재처리, 권한, 삭제 정책이 따라옵니다. AI는 미래인데 장애 대응은 원시시대인 경우가 많은 이유가 여기입니다. 결과 파일 관리를 대충하면 나중에 링크 만료나 권한 문제로 다시 ffprobe가 아니라 curl부터 붙잡게 됩니다.
텍스트 LLM은 어디에 쓰나
이미지와 영상 생성만 보면 AIGC가 그냥 “그림 뽑기”처럼 보이지만, 실제로는 텍스트 LLM이 앞단에서 꽤 중요합니다.
예를 들어 이런 작업에 쓸 수 있습니다.
| 작업 | 설명 |
|---|---|
| 원본 영상 요약 | 긴 VOD 자산을 짧게 설명 |
| 숏폼 기획안 생성 | 긴 영상에서 짧은 클립 아이디어 추출 |
| 이미지 프롬프트 생성 | 브랜드 톤에 맞는 visual prompt 생성 |
| 다국어 제목/설명 생성 | 글로벌 서비스용 메타데이터 생성 |
| 모더레이션 보조 | 태그와 설명 기반 위험 콘텐츠 후보 분류 |
OpenAI 호환 Text API가 있다는 건 이 지점에서 의미가 있습니다. 이미 있는 LLM 도구나 agent workflow가 OpenAI SDK를 쓰고 있다면, gateway만 바꿔서 붙일 수 있습니다. 물론 모델별 reasoning 옵션 지원은 다르니, 클라이언트에서 모델별 파라미터 화이트리스트를 두는 게 안전합니다.
curl -X POST https://text-aigc.vod-qcloud.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-5.5",
    "messages": [
      {
        "role": "user",
        "content": "이 제품 데모 영상을 30초 숏폼 광고 콘셉트로 바꿔줘."
      }
    ],
    "reasoning_effort": "low",
    "stream": false
  }'
여기서 중요한 건 LLM이 혼자 콘텐츠를 완성한다기보다, 미디어 workflow의 앞단에서 프롬프트와 메타데이터를 정리해준다는 점입니다. 결국 영상 생성 품질은 프롬프트, reference asset, 모델 파라미터, 후처리 workflow가 같이 만듭니다. 모델만 바꾸면 갑자기 모든 게 좋아진다는 건 보통 데모 영상에서만 안정적으로 동작합니다.
모델 선택에서 조심할 점
AIGC 게이트웨이에 여러 모델이 들어와 있다는 건 장점이지만, 동시에 운영 복잡도이기도 합니다.
| 체크 포인트 | 이유 |
|---|---|
| 지원 aspect ratio | 모델마다 허용 비율이 다름 |
| resolution 표기 | 1080P 라벨인지 1920x1080 픽셀인지 다름 |
| reference image 지원 | t2i만 되는 모델과 i2i 지원 모델이 갈림 |
| safety check 옵션 | 모델별 입력/출력 검수 옵션 차이 |
| timeout | 영상 모델은 task 시간이 크게 흔들림 |
특히 aspect ratio와 resolution은 매핑 테이블을 두는 게 좋습니다. 16:9를 요청하면서 1024x1024 같은 값을 같이 보내면 모델 입장에서는 앞뒤가 안 맞습니다. 여기서 에러 메시지가 친절하면 좋겠지만, 실제로는 “invalid parameter” 한 줄로 끝나는 경우가 많습니다. 로그 보다 보면 새벽 4시에 인간성이 사라지는 타입입니다.
언제 쓰면 좋을까
Tencent Cloud VOD AIGC는 이런 경우에 잘 맞습니다.
- 이미 Tencent Cloud VOD나 MPS를 쓰고 있고, 생성 결과를 같은 미디어 파이프라인에 넣고 싶을 때
- 여러 텍스트/이미지/영상 모델을 한 계정과 과금 체계로 묶고 싶을 때
- VOD 자산에서 요약, 썸네일, 키 비주얼, 숏폼 영상을 자동 생성하고 싶을 때
- OpenAI 호환 SDK 기반 도구를 유지하면서 backend gateway만 바꾸고 싶을 때
- 모델 비교 PoC를 빠르게 돌리고 싶을 때
반대로 단일 모델만 쓰고, 자체 LoRA 학습이나 fine-tuning이 핵심이라면 이 구조는 맞지 않을 수 있습니다. VOD AIGC는 inference gateway에 가깝습니다. 모델 학습 플랫폼이라기보다 여러 모델을 호출하고 결과를 미디어 workflow로 연결하는 계층이라고 보는 게 정확합니다.
한계
첫째, 모델별 파라미터 차이가 있습니다. 한 API처럼 보이지만 내부에는 여러 모델이 있습니다. 같은 Prompt라도 aspect, resolution, reference image 지원 여부가 다릅니다. 통합 게이트웨이라는 말만 믿고 공통 옵션을 무작정 밀어 넣으면 바로 터집니다.
둘째, 비동기 task 운영이 필요합니다. 이미지 정도는 금방 끝나지만 영상은 오래 걸립니다. 사용자 화면에서 결과를 기다리게 할 거라면 task status를 별도 관리해야 합니다.
셋째, 생성 결과의 권리와 검수 문제를 따로 봐야 합니다. 모델이 뽑은 결과라고 해서 서비스에 바로 올려도 된다는 뜻은 아닙니다. 브랜드, 저작권, 콘텐츠 정책 검수는 여전히 필요합니다. AI가 만들어도 운영 책임은 사람한테 옵니다. 이건 기술 문제가 아니라 제품 운영 문제입니다.
정리
Tencent Cloud VOD AIGC는 VOD 안에 붙은 생성형 AI 기능이라기보다, 미디어 자산을 중심으로 텍스트, 이미지, 영상 생성 모델을 호출하는 게이트웨이에 가깝습니다. 텍스트 API는 OpenAI 호환성을 제공하고, 이미지와 영상은 MPS의 비동기 task 모델로 처리됩니다.
실습 관점에서 보면 흐름은 명확합니다. 프롬프트로 이미지를 만들고, 그 이미지를 reference로 삼아 짧은 영상을 생성하고, 결과를 다시 VOD 자산 흐름에 태우면 됩니다. 이때 진짜 중요한 건 모델 이름보다 task 상태 관리, 결과 URL 관리, 후처리 workflow입니다.
생성형 AI는 멋있지만, 서비스에 넣는 순간 그냥 또 하나의 미디어 처리 job이 됩니다. 결국 마지막엔 callback, retry, timeout, storage policy가 품질을 결정합니다. 모델이 영상을 뽑고, 운영자는 그 영상이 어디에 저장됐는지 찾아다니는 구조가 되면 이미 늦습니다.
참고 1: Tencent Cloud VOD product page - https://www.tencentcloud.com/document/product/266
참고 2: Tencent Cloud MPS product page - https://www.tencentcloud.com/document/product/862
관련해서 기본 VOD 구조는 Tencent Cloud VOD 쪽을 보면 되고, MPS의 처리 엔진 관점은 Tencent Cloud MPS (Media Processing Service)에서 이어서 보면 됩니다.