
[EdgeOne] AI Gateway 베타서비스 체험기
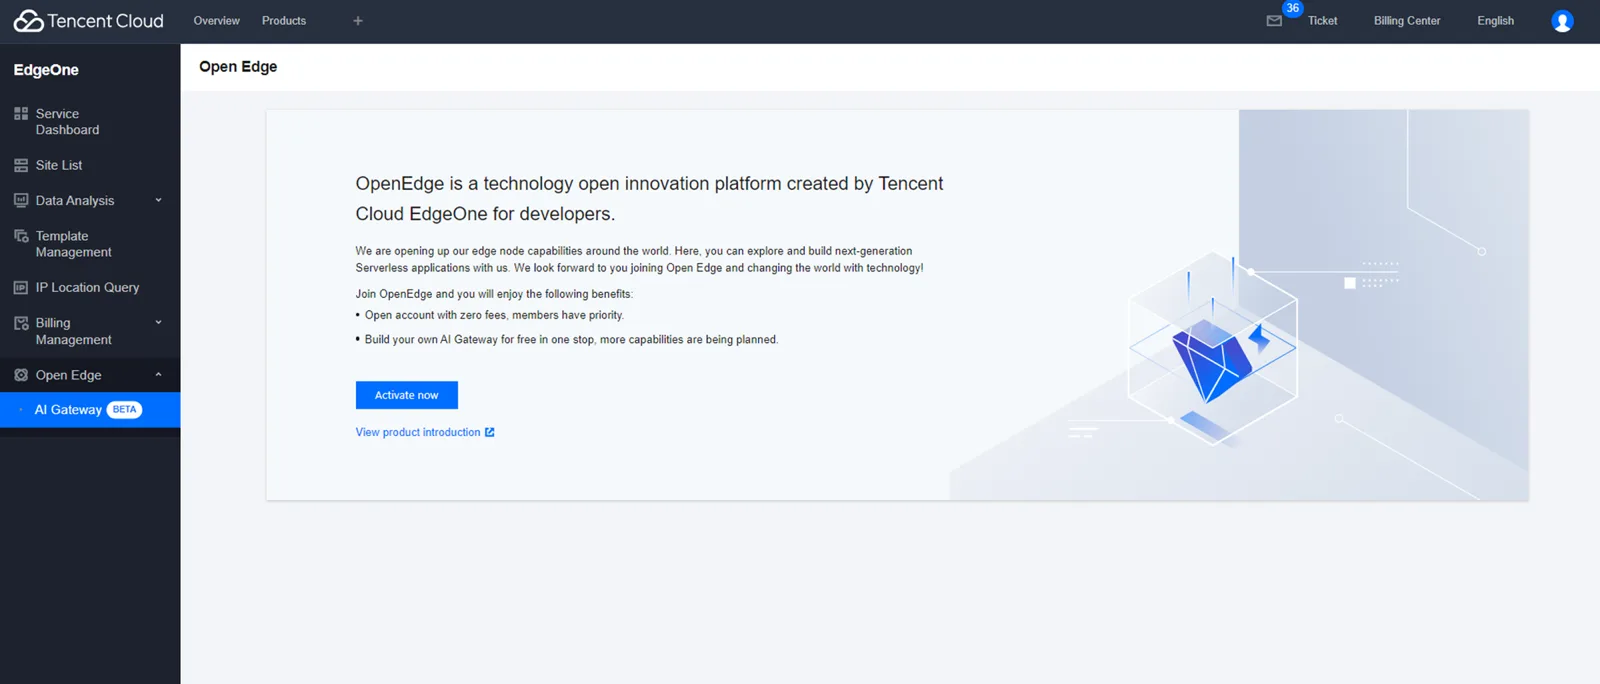
어느 날 Tencent Cloud EdgeOne 콘솔에서 새로운 메뉴를 발견했습니다.
Open Edge - AI Gateway 가 바로 그것입니다. 베타 버전이길래 제 계정에만 특별한 베타테스터 권한을 준 것인가 싶었지만 그렇지는 않았습니다. 우선 활성화를 위해 Activate Now를 클릭하고
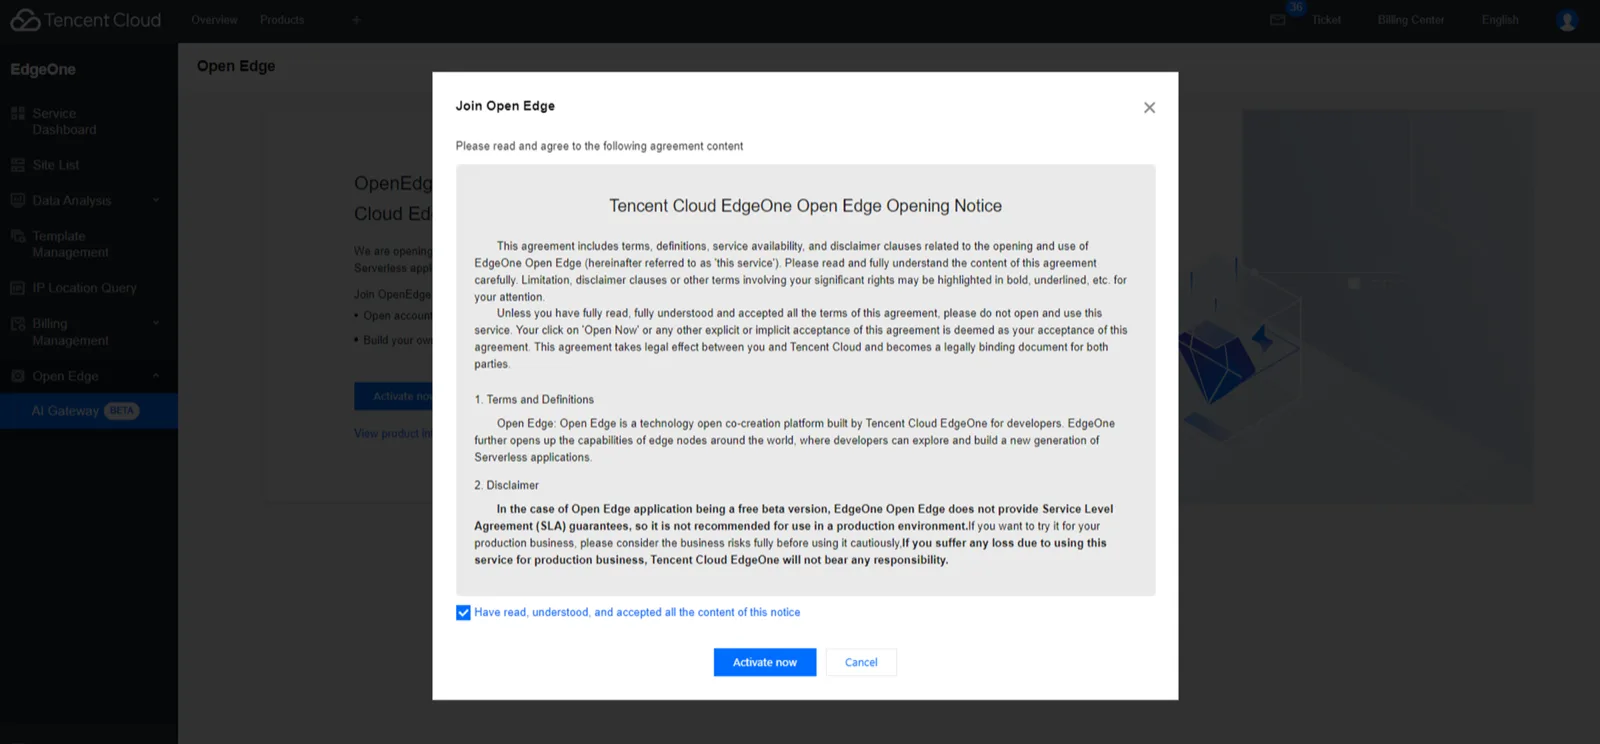
좋은 취지의 안내로 보여 동의하고 다시 Activate Now 버튼을 클릭했습니다.
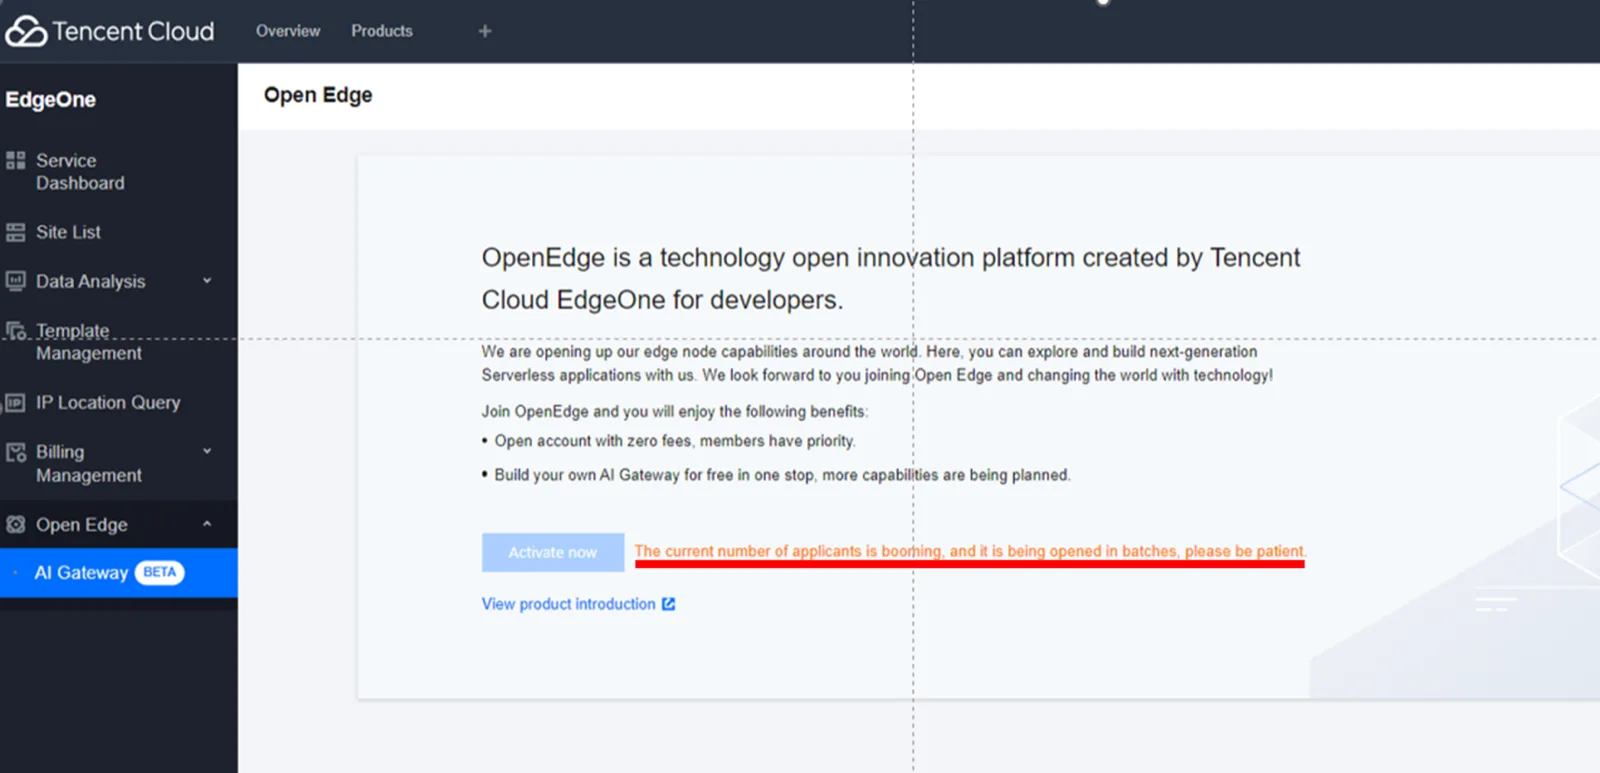
그런데 베타 버전 사용자 신청 대기가 많으니 인내심을 갖고 기다려 달라는 안내가 있었습니다. 생각보다 꽤 오랫동안 대기 상태가 지속되었는데, 며칠 뒤 우연히 클릭해보니 열려 있었습니다.
그 전에 OpenEdge와 AI Gateway가 무엇인지 먼저 파악해볼 필요가 있습니다.
Tencent Cloud EdgeOne - OpenEdge
엣지원 공식 문서(https://edgeone.ai/blog/details/open-edge)에서 설명하는 OpenEdge는 다음과 같습니다.
OpenEdge란 무엇인가? 더 많은 개발자들이 엣지 애플리케이션 개발에 참여하고, 협업하며, 개선할 수 있도록 Tencent EdgeOne은 OpenEdge라는 오픈 기술 공동 창작 플랫폼을 개발자들을 위해 만들었습니다. 우리는 전 세계적으로 우리의 엣지 노드 기능을 더욱 개방하여, 여러분이 우리와 함께 차세대 서버리스 애플리케이션을 탐구하고 구축할 수 있도록 합니다. 또한 다양한 애플리케이션 선택지와 함께 즉시 사용 가능한 경험을 제공하여, 개발자들이 공동으로 새로운 세대의 엣지 서버리스 애플리케이션을 탐구하고 구축하는 것을 지원하고 촉진합니다.
OpenEdge 아키텍처 개요 OpenEdge 아키텍처는 엣지 컴퓨팅 애플리케이션 작업을 하는 개발자들에게 원활한 경험을 제공하도록 설계되었습니다. 이는 서버리스 애플리케이션 계층, 엣지 컴포넌트 계층, 그리고 컴퓨팅 계층의 세 가지 주요 계층으로 구성됩니다. 각 계층은 엣지 애플리케이션의 효율적인 구현과 운영을 보장하는 데 중요한 역할을 합니다.
1. 서버리스 애플리케이션 계층 경량 애플리케이션에 초점을 맞춘 서버리스 애플리케이션 계층은 개발자들에게 유지 보수가 필요 없고 즉시 사용 가능한 경험을 제공합니다. 현재 우리는 개발자들이 대규모 언어 모델(LLMs)에 대한 접근을 관리하고 제어할 수 있도록 AI Gateway 애플리케이션을 무료로 제공하고 있습니다. 포스터 생성, 실시간 트랜스코딩, 텍스트-이미지 변환 등의 추가 애플리케이션들이 개발 중이며 곧 사용 가능해질 예정입니다.
2. 엣지 컴포넌트 계층 엣지 컴포넌트 계층은 엣지 애플리케이션 구현에 필수적인 핵심 구성 요소들로 이루어져 있습니다. 이 구성 요소들에는 Edge Functions, Edge Cache, Edge KV, Edge COS, Edge AI가 포함됩니다. 이러한 빌딩 블록들은 개발자들이 네트워크의 엣지에서 데이터를 효율적으로 처리하고 관리할 수 있는 강력하고 고성능의 애플리케이션을 만들 수 있게 해줍니다.
3. 엣지 컴퓨팅 계층 엣지 컴퓨팅 계층은 엣지 애플리케이션 구현에 필요한 컴퓨팅 파워를 제공합니다. 여기에는 CPU와 GPU 같은 이기종 리소스가 포함되어, 애플리케이션이 실시간으로 데이터를 효율적으로 처리하고 분석할 수 있도록 합니다. 이 계층은 엣지 애플리케이션이 IoT, AI, 실시간 분석 등의 산업에서 필수적인 저지연, 고성능 결과를 제공할 수 있도록 하는 데 중요한 역할을 합니다.
정리하면 OpenEdge는 CDN 인프라를 엣지 컴퓨팅 플랫폼으로 확장하여, 개발자들이 글로벌 네트워크에서 효율적으로 애플리케이션을 개발하고 실행할 수 있게 해주는 서비스로 볼 수 있습니다. Tencent Cloud가 운영하는 전 세계 엣지 노드를 단순한 CDN 서비스를 넘어 더 넓은 영역으로 발전시켜 나가는 시도로 보입니다.
다음은 AI Gateway에 대한 설명을 보면,
OpenEdge - AI Gateway
Tencent EdgeOne AI Gateway는 대규모 언어 모델(LLM) 서비스 제공업체에 접근할 때 보안, 가시성, 그리고 요청 행동 제어 관리를 제공합니다. 현재 AI Gateway는 개발자들이 무료 체험을 신청할 수 있도록 제공되고 있습니다.
AI Gateway는 캐시 구성 기능을 지원하고 있으며, 개발 중인 기능으로는 속도 제한, 요청 재시도, LLM 모델 폴백, 그리고 가상 키가 있습니다. 이러한 기능들의 조합은 LLM 서비스 제공업체에 접근할 때의 보안과 안정성을 효과적으로 보장하는 동시에 접근 비용을 줄여줍니다.
AI Gateway는 OpenEdge에서 지원하는 기능으로, 각종 AI 모델과 사용자 사이의 프록시 역할을 하여 LLM 모델을 좀 더 효율적으로 제어하는 서비스로 볼 수 있습니다. 현재 베타 버전이므로 이런 기능이 있다는 정도로 가볍게 체험해보겠습니다.
AI Gateway 베타 체험
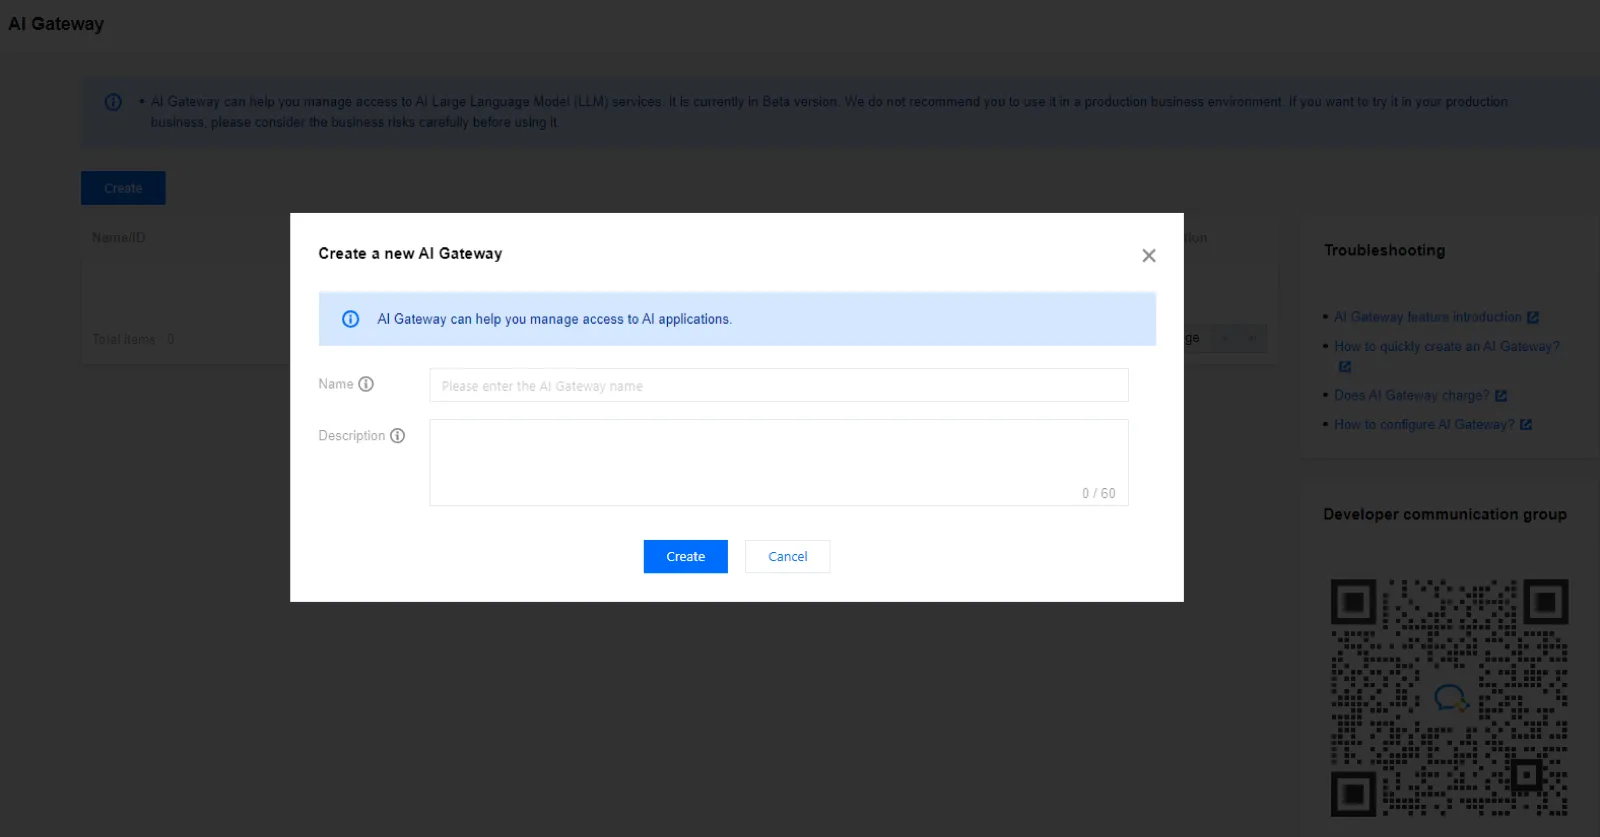
다시 이 창으로 돌아와서 Create를 클릭합니다.
생성할 AI Gateway의 기본 정보를 적어주고
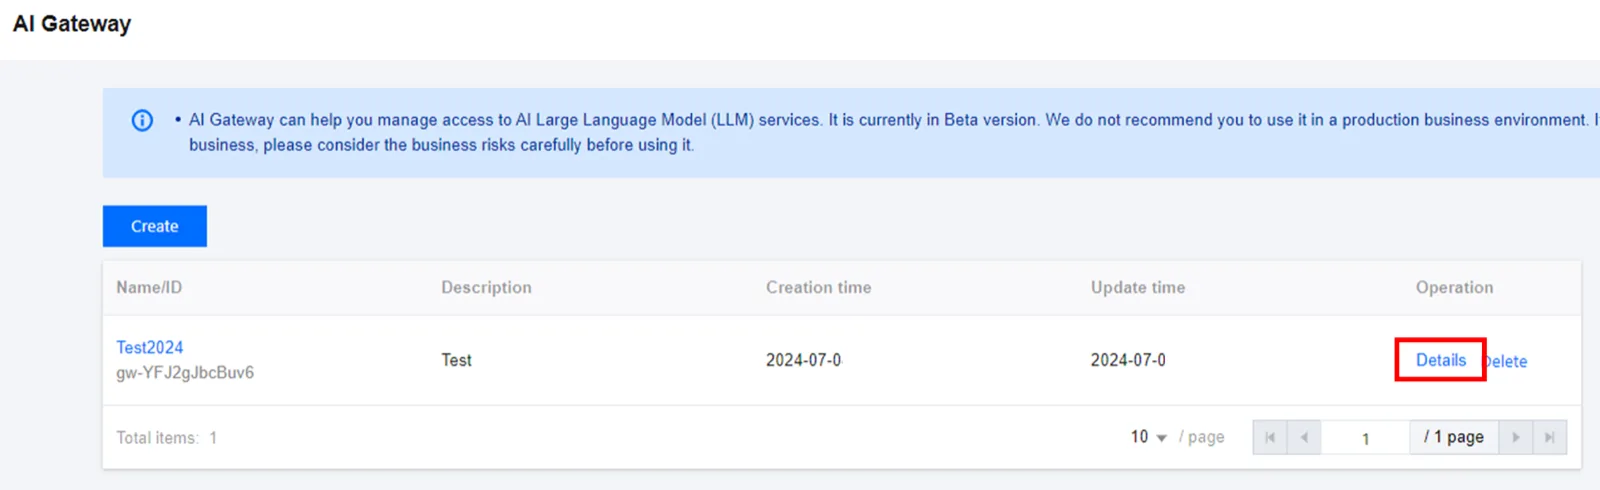
Details를 클릭하면
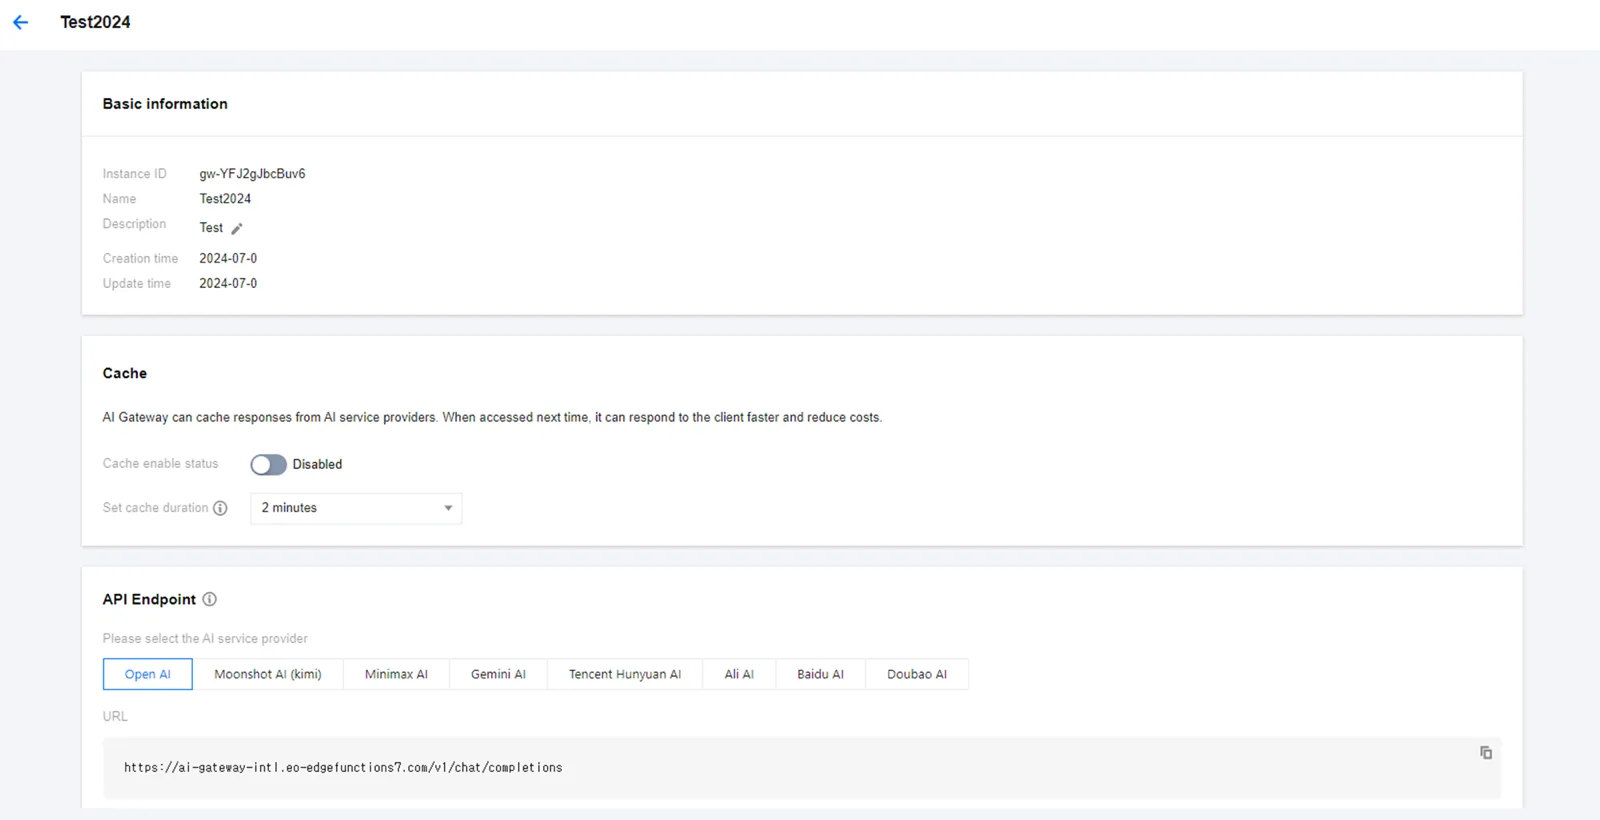
생성한 AI Gateway의 정보를 확인할 수 있습니다.
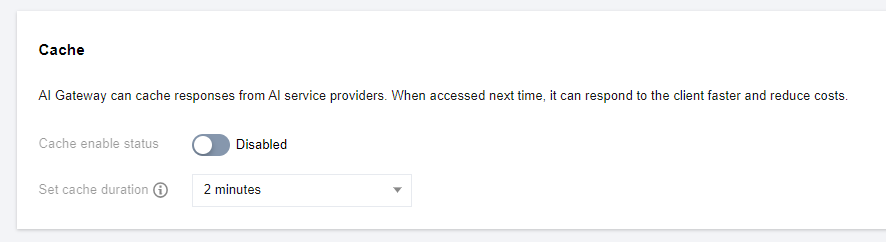
이때 Cache 항목이 있는데, 설명을 읽어보면 이 AI Gateway 프록시가 LLM플랫폼의 응답을 캐싱해놨다가 클라이언트가 동일한 유형의 질문을 하면 LLM플랫폼에 요청하지 않고 캐시된 응답을 클라이언트에게 돌려주는 기능으로 보인다. 보통의 LLM 모델들이 쿼리당 토큰을 기준으로 과금을 하는데 아마 이 기능을 사용하면 효과적으로 비용절감을 할 수 있을 것 같다.
예를 들면 다음과 같습니다.
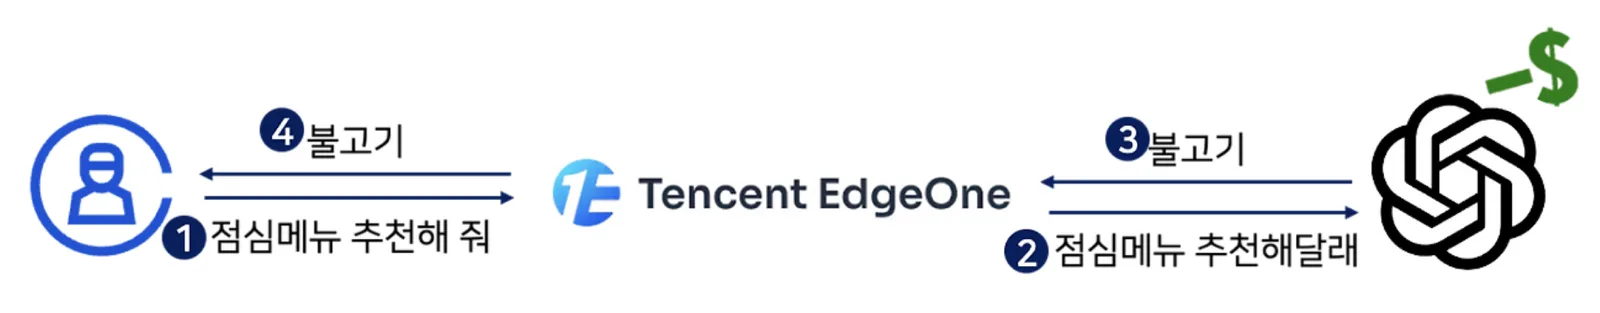
사용자가 GPT에 질문을 보내면, AI Gateway가 해당 질문에 대한 GPT의 답변이 캐싱되어 있는지 확인하고 없으면 ChatGPT에 질문합니다. 이때 GPT 호출의 대가로 토큰을 소모하게 되고 GPT가 응답한 답변을 AI Gateway가 사용자에게 전달해줍니다.
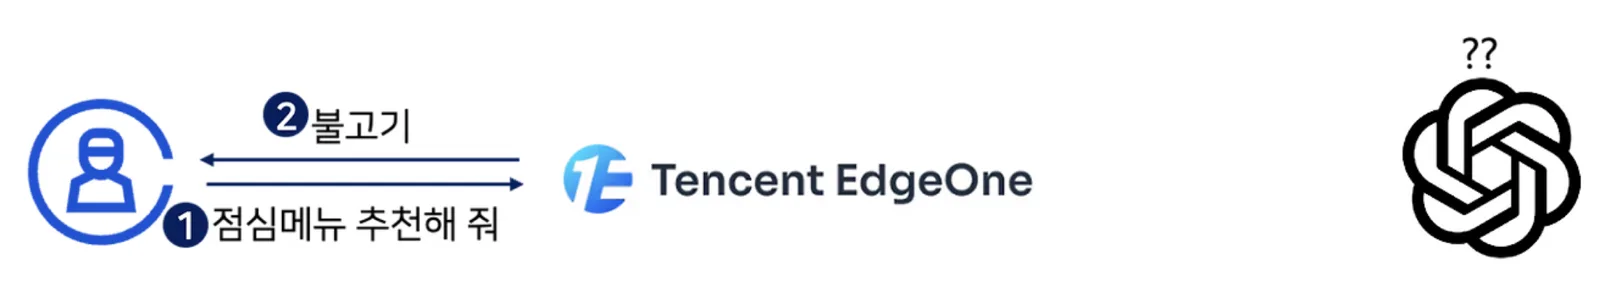
여기서 다른 사용자가 같은 질문을 하면 AI Gateway에 해당 질문에 대한 답변이 캐싱되어 있으므로(캐시 히트), GPT를 호출하지 않고 캐시된 답변을 사용자에게 전달합니다. 이때 GPT를 쿼리하지 않았으므로 토큰을 소모하지 않습니다. 일반적인 CDN의 원리와 같습니다.
실제로 테스트해보겠습니다. 예시를 살펴보면
AI Gateway의 chatGPT 호출 엔드포인트에 대해,
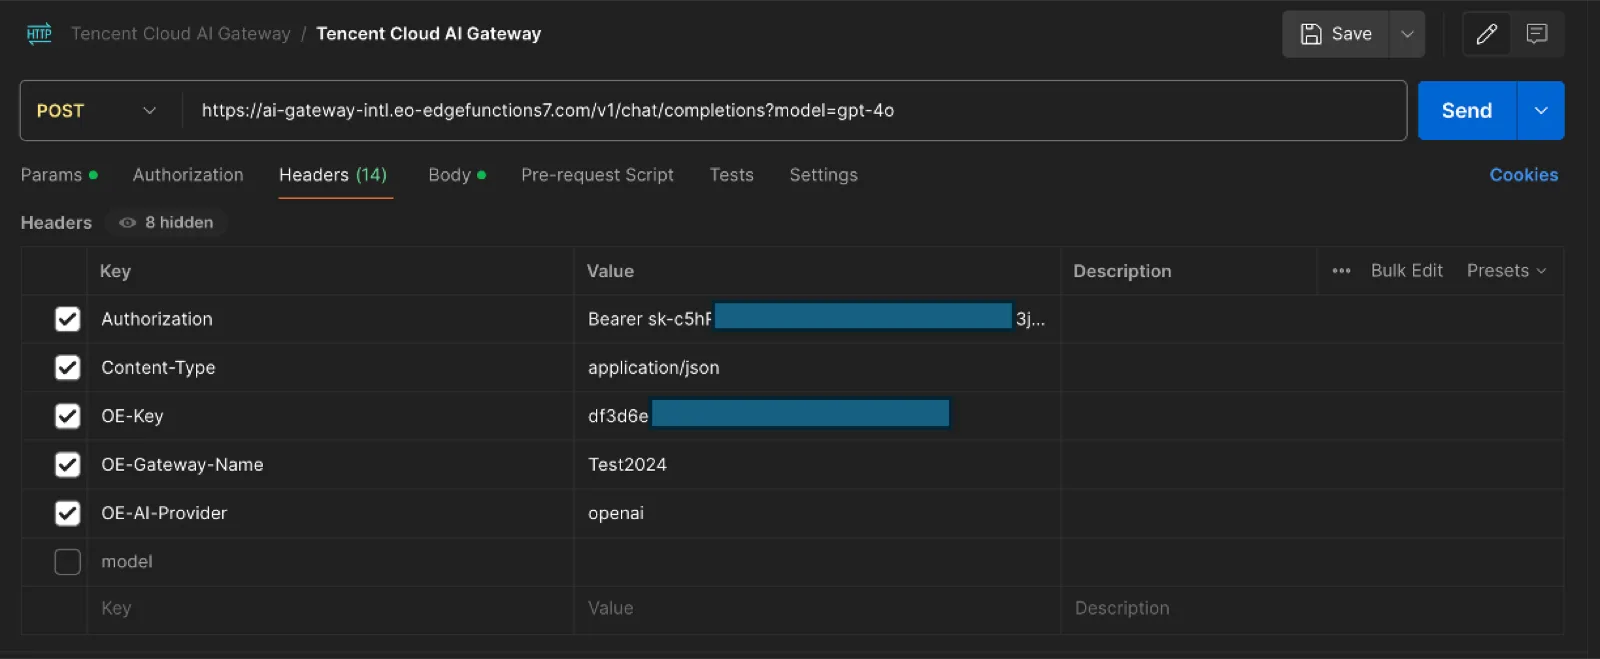
https://ai-gateway-intl.eo-edgefunctions7.com/v1/chat/completions요청 헤더 값과 Body의 내용을 참고하여 POST 요청을 보내면 됩니다.
curl -X POST "https://ai-gateway-intl.eo-edgefunctions7.com/v1/chat/completions" \
 -H 'Authorization: Bearer XXXXXXXXXX' \
 -H 'Content-Type: application/json' \
 -H 'OE-Key: df3d6ec8552840bfb311ed7dXXXXXXXXX' \
 -H 'OE-Gateway-Name: Test2024' \
 -H 'OE-AI-Provider: openai' \
 -d '{
  "model": "gpt-4o",
  "messages": [
    {
      "role": "system",
      "content": "You are a poetic assistant, adept at explaining complex programming concepts with creative talent."
    },
    {
      "role": "user",
      "content": "Write a poem to explain the concept of recursion in programming."
    }
  ]
}'
포스트맨을 사용하여 세팅을 하고 AI Gateway 설정에서 캐싱주기를 2분으로 한 뒤
테스트용 질문을 해보겠습니다. 필자는 한때 LLM 환각 현상의 예시로 화제였던 질문인 세종대왕 맥북프로 던짐사건에 대해 물어보았습니다.
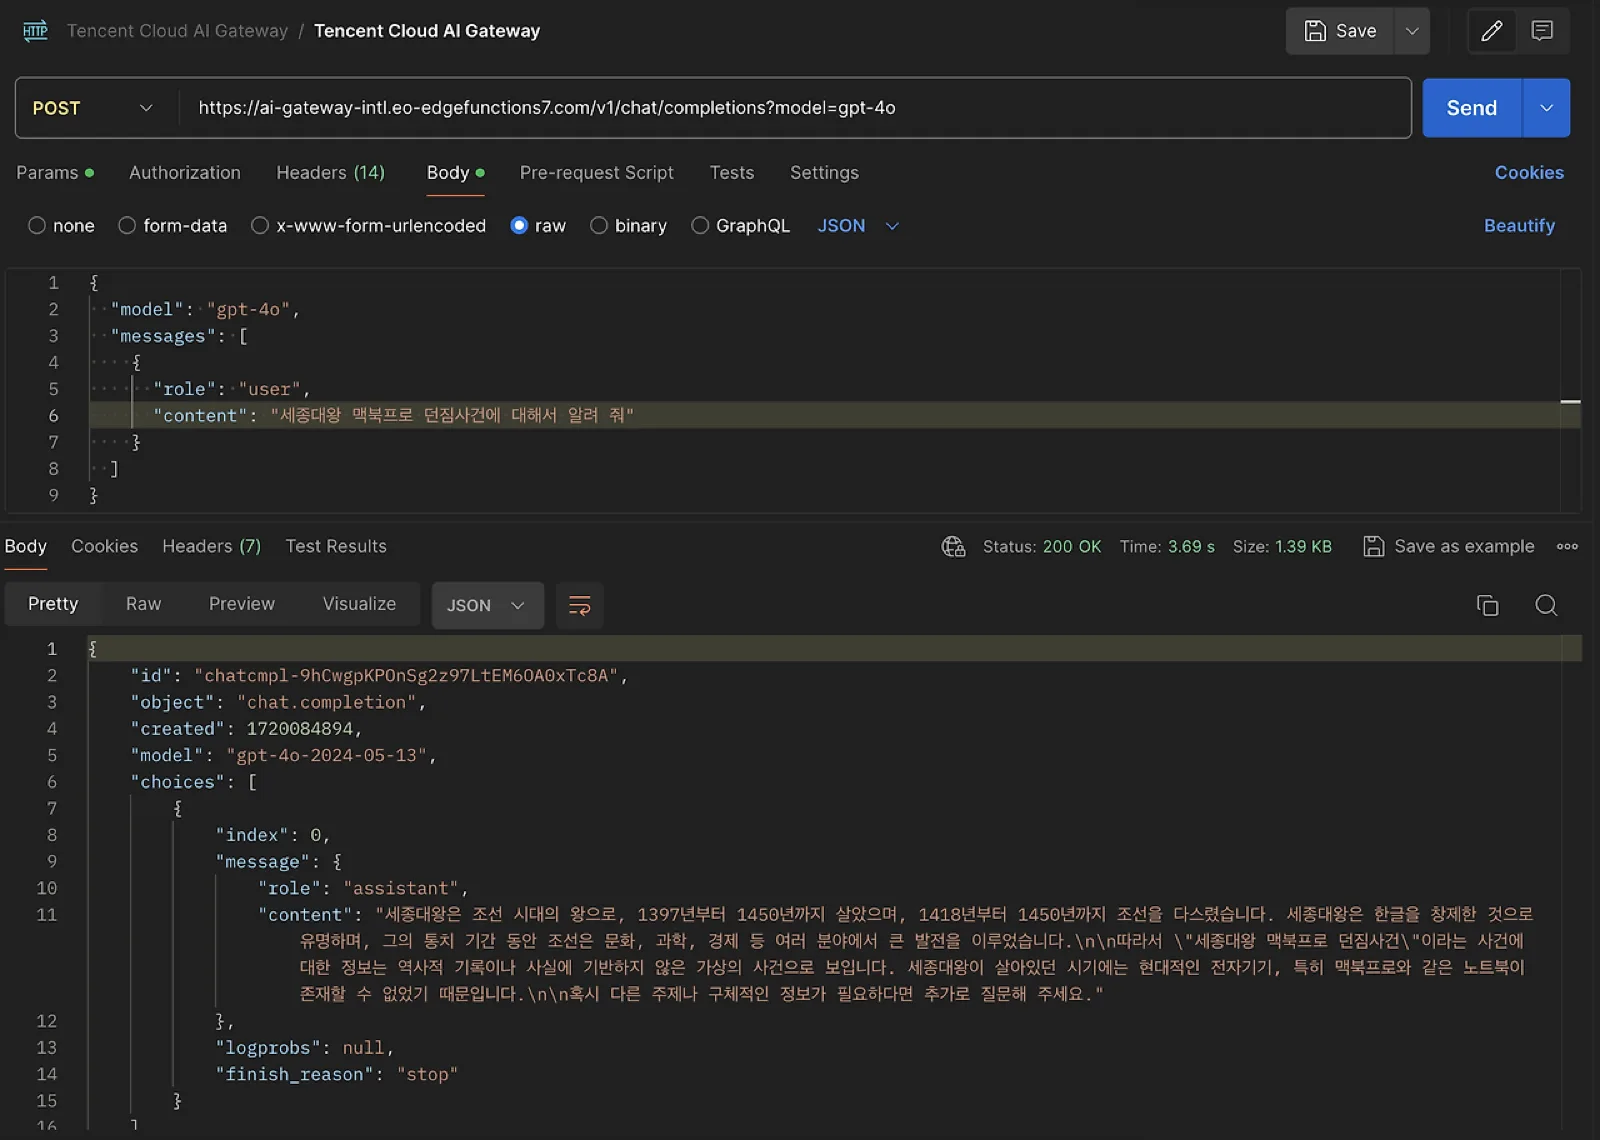
AI Gateway가 정상적으로 chatGPT에 클라이언트의 질문을 전달하고 답변을 받아서 전달해주는 모습입니다.
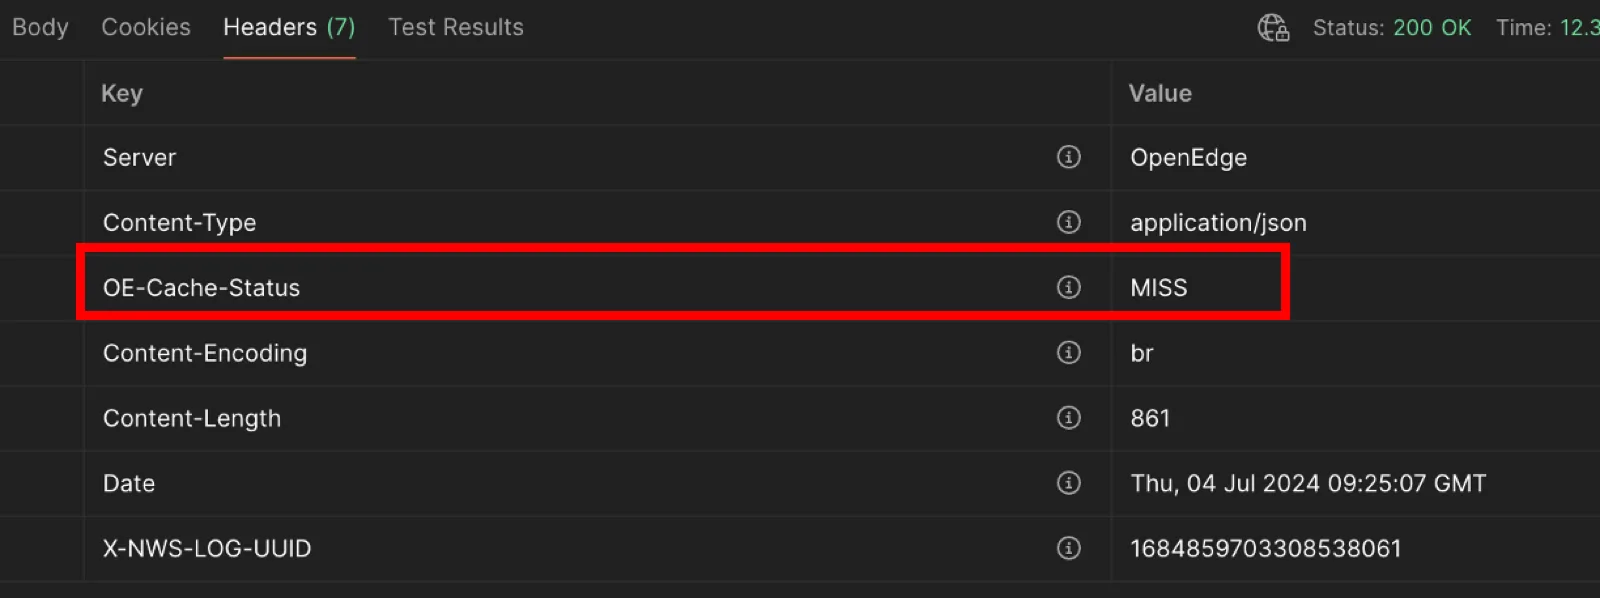
응답 헤더를 확인해보면, 첫 질문이므로 캐시 미스가 일어나는 것을 볼 수 있습니다.
GPT의 토큰 소모량을 보면
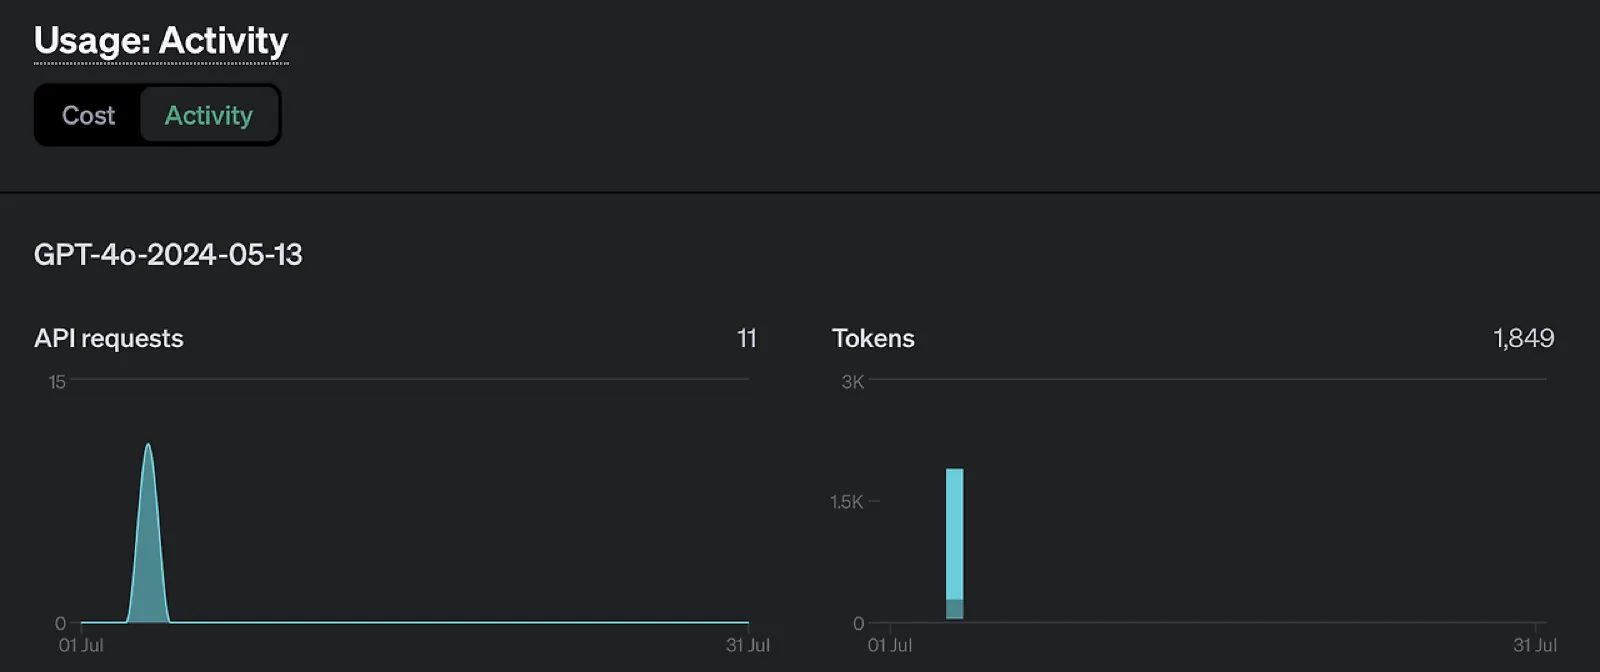
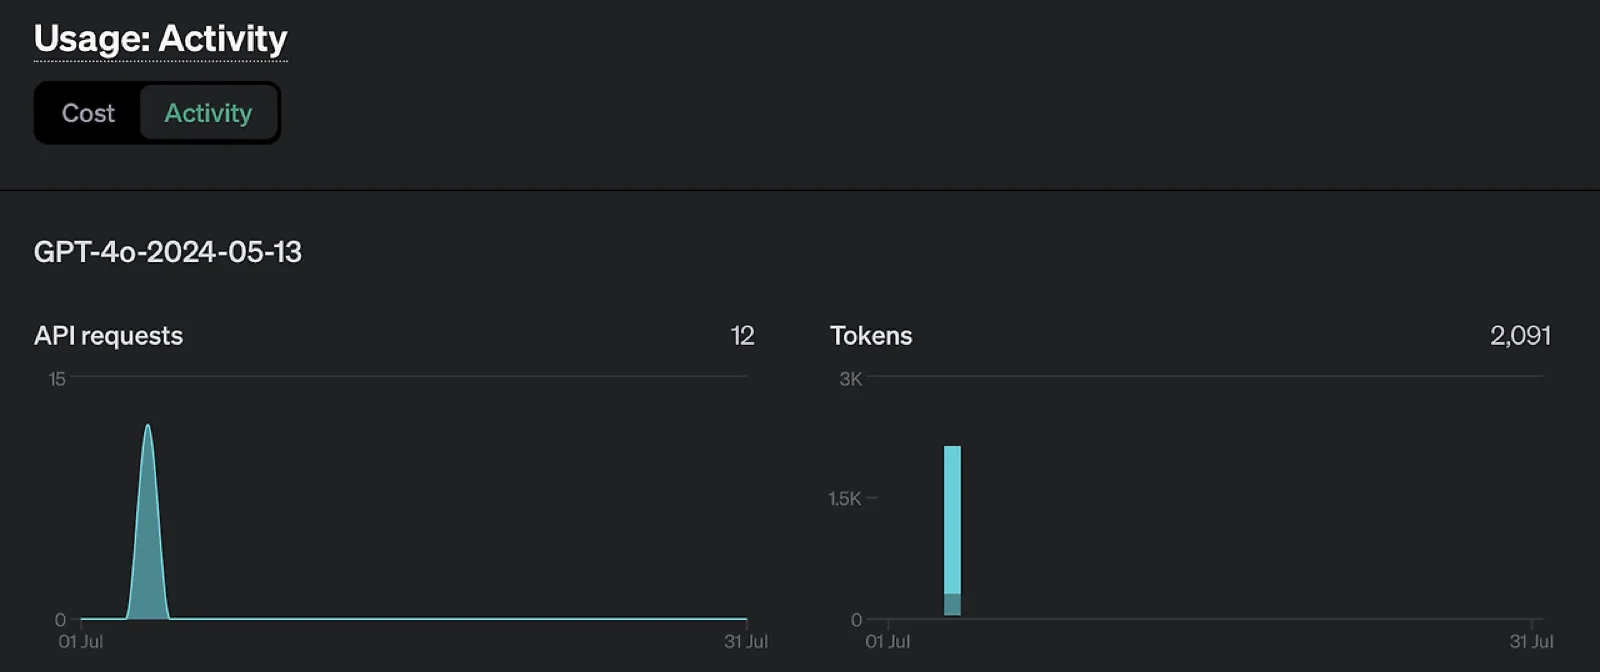
첫 질문 후 2091-1849 = 242의 토큰이 소모된 것을 알 수 있습니다.
캐싱 주기인 2분이 지나기 전에 같은 질문으로 다시 POST 요청을 날리면,
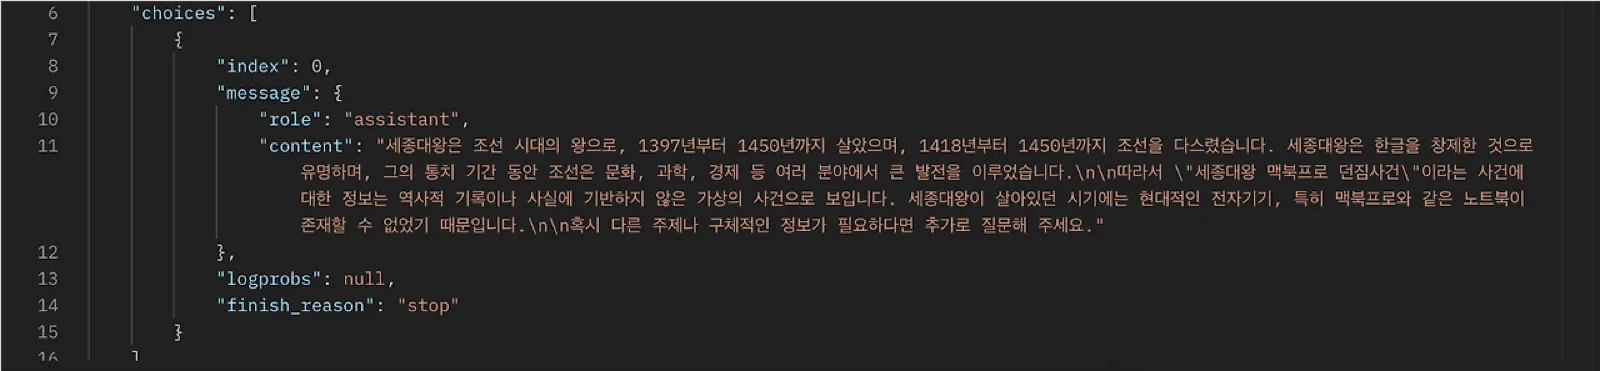
동일한 답변이 오고 다시 응답헤더를 확인해보면
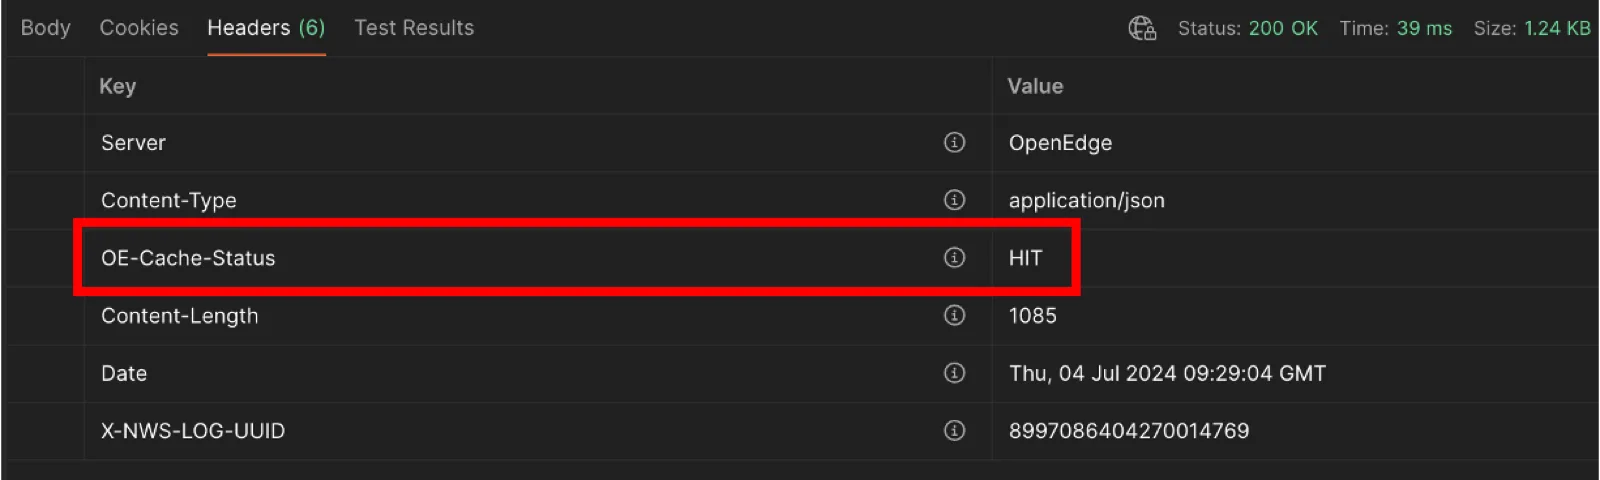
이번에는 캐시 히트가 일어난 것을 알 수 있습니다. 방금 답변은 GPT를 거치지 않고 AI Gateway가 가지고 있던 답변을 클라이언트가 받게 된 것입니다.
GPT의 API 토큰 소모현황을 다시 보면,
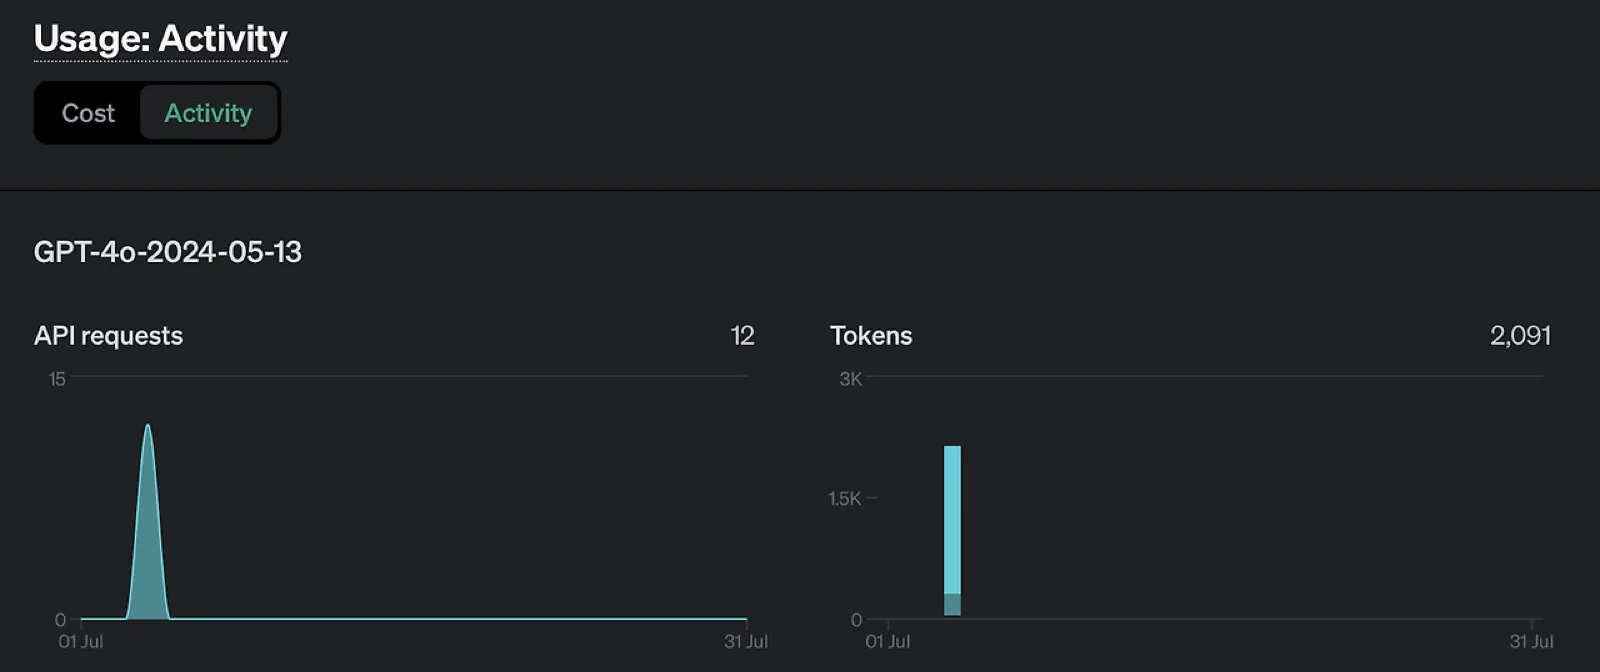
요청도 오지 않았고 당연히 토큰 소모도 없는 것을 확인할 수 있습니다.
마치며
이 글에는 베타 버전으로 공개된 Tencent Cloud의 AI Gateway 기능을 간단히 테스트하는 내용을 담았습니다. AI Gateway의 베타 오픈을 기점으로 OpenEdge 활용을 통한 많은 기능이 공개될 것으로 보입니다. Tencent Cloud가 보유한 방대한 엣지 노드와 AI의 결합이 어떤 식으로 발전될지 기대되는 부분입니다. 앞으로 Tencent Cloud International 콘솔에도 AI를 활용한 여러 상품이 추가될 것으로 예상되며, 이 부분을 계속 주목해볼 만합니다.